Wie in de media werkt en denkt dat de vervuiling van de wetenschap door taalmodellen vooral een zorg van universiteiten is, had woensdag in München moeten zitten. Daar liet de Amerikaanse hoogleraar Toby Stuart in een klein kwartier zien hoe snel het fundament onder ieder journalistiek product, het vertrouwen in de bron, aan het verschuiven is.
Ik was bij AI@STRATEGY, het congres dat de TUM School of Management op 7 en 8 oktober organiseerde over de invloed van AI op leiderschap, werk en de waardeketen. Hoewel de onder de toespraken veelal strategen en bedrijfseconomen zaten, bleef vooral Stuarts lezing hangen. Dit omdat de hoogleraar aan de Haas School of Business in Berkeley zijn betoog opende met de observatie dat wat nu in de wetenschap gebeurt, uiteindelijk ook elders zichtbaar wordt.
Stuart en zijn collega’s publiceerden in Science een studie naar wetenschappelijke productie in het tijdperk van AI-taalmodellen. Onderzoekers die hun manuscripten met een LLM opstellen, blijken afhankelijk van hun vakgebied en achtergrond 23,7 tot 89,3 procent meer artikelen te produceren. Dat gereedschap dat het schrijven versnelt ook meer geschreven werk oplevert, is op zichzelf niet verrassend. Interessanter is dat het gebruikelijke verband tussen taalkundige complexiteit en inhoudelijke kwaliteit omkeert. Verfijnde formuleringen wijzen daardoor niet langer vanzelf op sterk onderzoek en kunnen evengoed voorkomen in manuscripten die stilistisch complex en inhoudelijk zwak zijn, terwijl redacties stijl en toon al decennia gebruiken als een eerste, informele aanwijzing dat iemand niet alleen precies formuleert maar vermoedelijk ook precies heeft gedacht.
Het vervolgonderzoek dat Stuart in München presenteerde, maakt duidelijk hoe snel ook de bronnen-laag verandert. Zijn team controleerde ongeveer 111 miljoen literatuurverwijzingen in zo’n 2,5 miljoen papers op arXiv, bioRxiv, SSRN en PubMed Central en zag dat het aantal verwijzingen naar niet-bestaande publicaties jarenlang min of meer vlak bleef, om na de introductie van ChatGPT scherp te stijgen. Voor 2025 komen de onderzoekers uit op een voorzichtige schatting van 146.932 verzonnen citaties, waarvan moderatie en peer review slechts een deel onderscheppen. Auteurs met gehallucineerde verwijzingen bleken bovendien hun productieachterstand op vergelijkbare collega’s in korte tijd volledig te hebben ingelopen, waardoor slordigheid binnen een beoordelingssysteem dat aantallen beloont en pas achteraf controleert gemakkelijk op productiviteit kan gaan lijken.
Voor de mediasector is vooral van belang hoe een taalmodel zo’n bron verzint. Een niet-bestaande publicatie wordt doorgaans toegeschreven aan een echte wetenschapper die inhoudelijk precies bij het onderwerp past, met een duidelijke voorkeur voor mannen die al veel hebben gepubliceerd en daardoor gezag bezitten. Omdat de naam, het vakgebied en de titel aannemelijk klinken, komt zo’n verwijzing gemakkelijk door een oppervlakkige controle op plausibiliteit. Het model automatiseert daarmee wat socioloog Robert Merton het Mattheüseffect noemde. Dat ishet mechanisme waarbij wie al gezag heeft steeds meer erkenning krijgt, en gebruikt tegelijk de reputatie van bestaande mensen als dekmantel voor fictie. De term verwijst naar het evangelie van Mattheüs, waarin staat dat aan wie heeft, gegeven zal worden, terwijl van wie niet heeft zelfs het weinige wordt afgenomen.
Dat de schade niet bij de bibliografie blijft, liet Stuart zien met een voorbeeld uit de beveiligingswereld. Onderzoekers van Palo Alto Networks beschreven in juni hoe criminelen domeinnamen registreren die taalmodellen voor bestaande merken verzinnen, een praktijk die zij ‘phantom squatting’noemen. In hun onderzoek naar 2,1 miljoen door AI gegenereerde links vonden ze ongeveer 250.000 nog niet geregistreerde fantasiedomeinen, terwijl ruim dertienduizend links al naar kwaadaardige pagina’s verwezen. Daarmee verandert ook de betekenis van een werkende link, want een pagina kan bestaan doordat een taalmodel haar eerst heeft verzonnen en iemand het adres daarna heeft geregistreerd; de redactionele controle bevestigt in dat geval niet de bron, maar voltooit de hallucinatie.
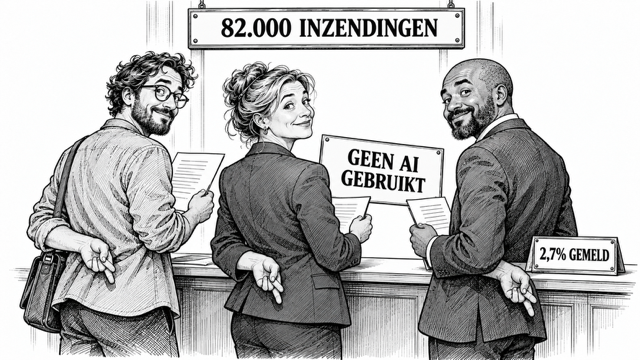
Achter de curven stelde Stuart een vraag die in de academische wereld al moeilijk te beantwoorden is: hoe neem je mensen aan, beoordeel je hun werk en besluit je wie promotie verdient als niet meer duidelijk is wie het werk heeft gedaan? Hij noemde zijn voormalige collega Nick Polson in Chicago, die volgens een telling van econoom Jeremy Horpedahl eind augustus al 258 papers op SSRN had geplaatst in 2026, waarbij zijn coauteur erkende dat het gebruik van AI niet consequent was vermeld. Bij de tijdschriften van JAMA Network meldde tussen september 2023 en mei 2025 intussen slechts 2,7 procent van de ruim 82.000 inzenders AI te hebben gebruikt, een percentage waarbij iedere redactie die werkt met freelancers, persberichten en ingezonden opiniestukken haar eigen vermoedens kan hebben…
De ontwikkeling wordt voortgedreven door kapitaal. Amazon, Microsoft, Alphabet, OpenAI, X, Anthropic en Meta trekken dit jaar samen honderden miljarden dollars uit voor AI-infrastructuur, waardoor niet alleen de productie groeit maar ook de hoeveelheid materiaal waarvan oorsprong en betrouwbaarheid niet onmiddellijk zijn vast te stellen. Stuart sloot zijn lezing af met de observatie dat de typische woordkeus van chatbots inmiddels doordringt in gewone gesprekken: modellen leerden schrijven door menselijke taal te verwerken, waarna mensen formuleringen van die modellen begonnen over te nemen. Ook de menselijke stem verliest zo iets van haar oude functie als bewijs van echtheid.
Wat de wetenschap nu in miljoenen datapunten meet, zal zich in de journalistiek vermoedelijk minder ordelijk aandienen. Het kan gaan om een citaat dat nergens terug te vinden is, om een deskundige die iets nooit heeft gezegd of om een website die pas werd geregistreerd nadat een model het adres had bedacht. De lastigste gevallen zullen waarschijnlijk niet de stukken zijn die vreemd of slordig ogen, maar de teksten waarin de namen, verwijzingen en formuleringen zich zonder zichtbare wrijving voegen naar wat een redactie verwacht. Zonder dat er aan de tekst zelf iets merkwaardigs te zien is. Waarin niets onmiddellijk opvalt…