Blog door Frank Mekkelholt, Manager Tech & Innovatie bij Bindinc.
Bij Bindinc. bouwen we aan de Content Value Engine: een pijplijn waarmee we op grote schaal metadata uit video halen. Hiervoor gebruiken we dure commerciële AI-modellen, maar steeds vaker ook concurrerende open modellen. En dat heeft grote voordelen.
Van metadata naar inzicht
Die metadata is voor ons geen doel op zich. We gebruiken de informatie om concrete vragen over videocontent te beantwoorden. Denk bijvoorbeeld aan de vraag hoe het aanbod van publieke omroepen zich verhoudt tot doelen als pluriformiteit, hoe content beter vindbaar wordt en hoe redactionele processen slimmer kunnen worden ingericht.
Voor die analyses gebruiken we nu vooral grote commerciële AI-modellen, zoals Gemini en Claude. Onze metadata-redactie controleert en verbetert de resultaten. Met die correcties leren we hoe we de modellen beter kunnen aansturen.
Maar er verandert iets. Open AI-modellen worden steeds beter. En dat roept een interessante vraag op: hebben we voor iedere analyse nog wel die grote commerciële modellen nodig?
Open modellen halen in
Open modellen zijn AI-modellen die je zelf kunt downloaden, in je eigen omgeving kunt draaien en verder kunt trainen. Bij het analyseren van videocontent presteerden ze lange tijd minder goed dan grote commerciële modellen, maar die achterstand wordt kleiner.
In onze eigen tests zien we dat open modellen bij sommige analyses inmiddels in de buurt komen van Gemini en Claude. Openbare benchmarks laten een vergelijkbare ontwikkeling zien. Bij ingewikkeldere taken, zoals het volgen van een verhaallijn door een lange uitzending heen, hebben de grote modellen nog steeds een voorsprong.
Dat roept voor ons een interessante vraag op: waarom zou je voor iedere analyse hetzelfde, zwaarste model gebruiken?
Een regisseur verdeelt het werk
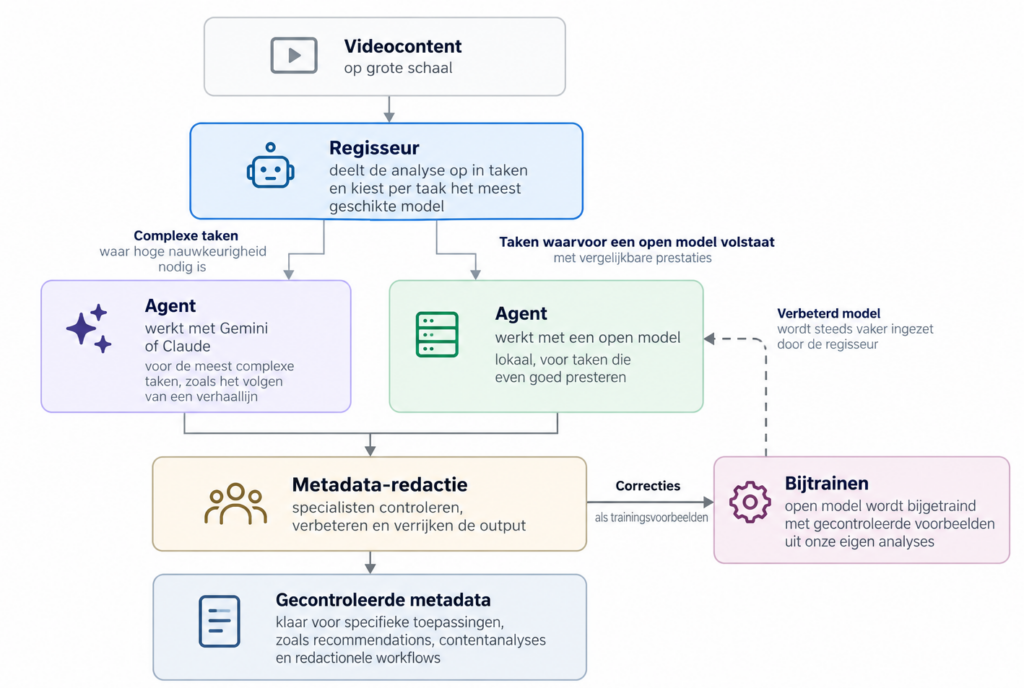
Daarom bouwen we nu agentic AI in de Content Value Engine. Je kunt dat zien als een regisseur die het werk verdeelt. De regisseur deelt de analyse van een programma op in taken en wijst iedere taak toe aan een agent: een AI-hulp die een specifiek onderdeel uitvoert. Vervolgens bepaalt de regisseur welk model daarvoor het meest geschikt is. Presteert een open model even goed als Gemini of Claude? Dan krijgt het voorrang en draait dat deel van de analyse op onze eigen hardware.
Dat heeft praktische voordelen. Videoanalyse met grote modellen is kostbaar. Volgens Google vertegenwoordigt één uur video al snel 360.000 tot ruim een miljoen tokens. Tokens zijn de eenheden waarop de kosten van deze modellen worden gebaseerd. Door modellen slim te combineren, kunnen we kosten beperken en worden we minder afhankelijk van externe aanbieders. Bovendien hoeft beeldmateriaal voor een deel van de analyses onze eigen omgeving niet te verlaten.
Trainen met onze eigen redactie
Voor mij zit hier nog een interessanter voordeel. Grote commerciële modellen kunnen we uitgebreid instrueren, maar we kunnen ze niet zelf verder trainen. Bij open modellen kan dat wel. We kunnen ze voorbeelden geven uit ons eigen werk en ze daarmee steeds beter maken in specifieke taken. Onze metadata-redactie speelt daarin een belangrijke rol. Iedere correctie van onze specialisten is namelijk ook trainingsdata: een voorbeeld van een analyse met daarbij het juiste antwoord.
Dat is vooral interessant bij Nederlandse videocontent. Een algemeen model heeft veel kennis, maar begrijpt niet automatisch hoe wij bijvoorbeeld genres afbakenen, welke context relevant is of hoe begrippen binnen het Nederlandse medialandschap worden toegepast. Door een model te trainen met onze eigen voorbeelden kan het steeds beter aansluiten op die specifieke context. En hoe beter een open model wordt, hoe vaker de regisseur het kan inzetten.
Zo ontstaat eigenlijk een vliegwiel: de redactie verbetert de analyses, die correcties verbeteren het model en het betere model neemt vervolgens meer analyses over.
De modellen zijn maar het begin
Toch zit voor mij het belangrijkste verschil niet in de AI-modellen zelf. Die technologie wordt voor steeds meer partijen bereikbaar. Een model kan uitstekend herkennen wat er in een video gebeurt. Maar daarmee weet je nog niet wat je met die informatie moet doen.
Daarom vertalen we bij Bindinc. de ruwe metadata naar specifieke frameworks. Daarin bepalen we welke kenmerken relevant zijn en hoe we die kunnen gebruiken om concrete vraagstukken op te lossen.
Voor NLZIET gebruiken we contentanalyse om metadata voor de recommender te verbeteren. Voor de NPO gaat het om analyses rond labeling, context en framing. En bij KRO-NCRV gebruiken we videoanalyse om redactionele processen te automatiseren.
De onderliggende technologie is grotendeels hetzelfde, maar de toepassingen verschillen. En juist dat maakt de ontwikkeling van onze Content Value Engine voor mij interessant. We bouwen aan een infrastructuur waarmee we uiteenlopende vragen over videocontent kunnen beantwoorden.
Modellen die we zelf trainen, maken de ruwe data beter en goedkoper. Onze op maat gemaakte frameworks vertalen die data naar bruikbare oplossingen.